行业观点 · 2026-08-29
GLM-5.3 与 GLM-5.3-Flash 怎么选:先看工作负载,不看后缀
GLM-5.3 强化复杂 Coding 与长链路任务,GLM-5.3-Flash 强调原生多模态和推理效率;选型应回到质量、成本与风险。
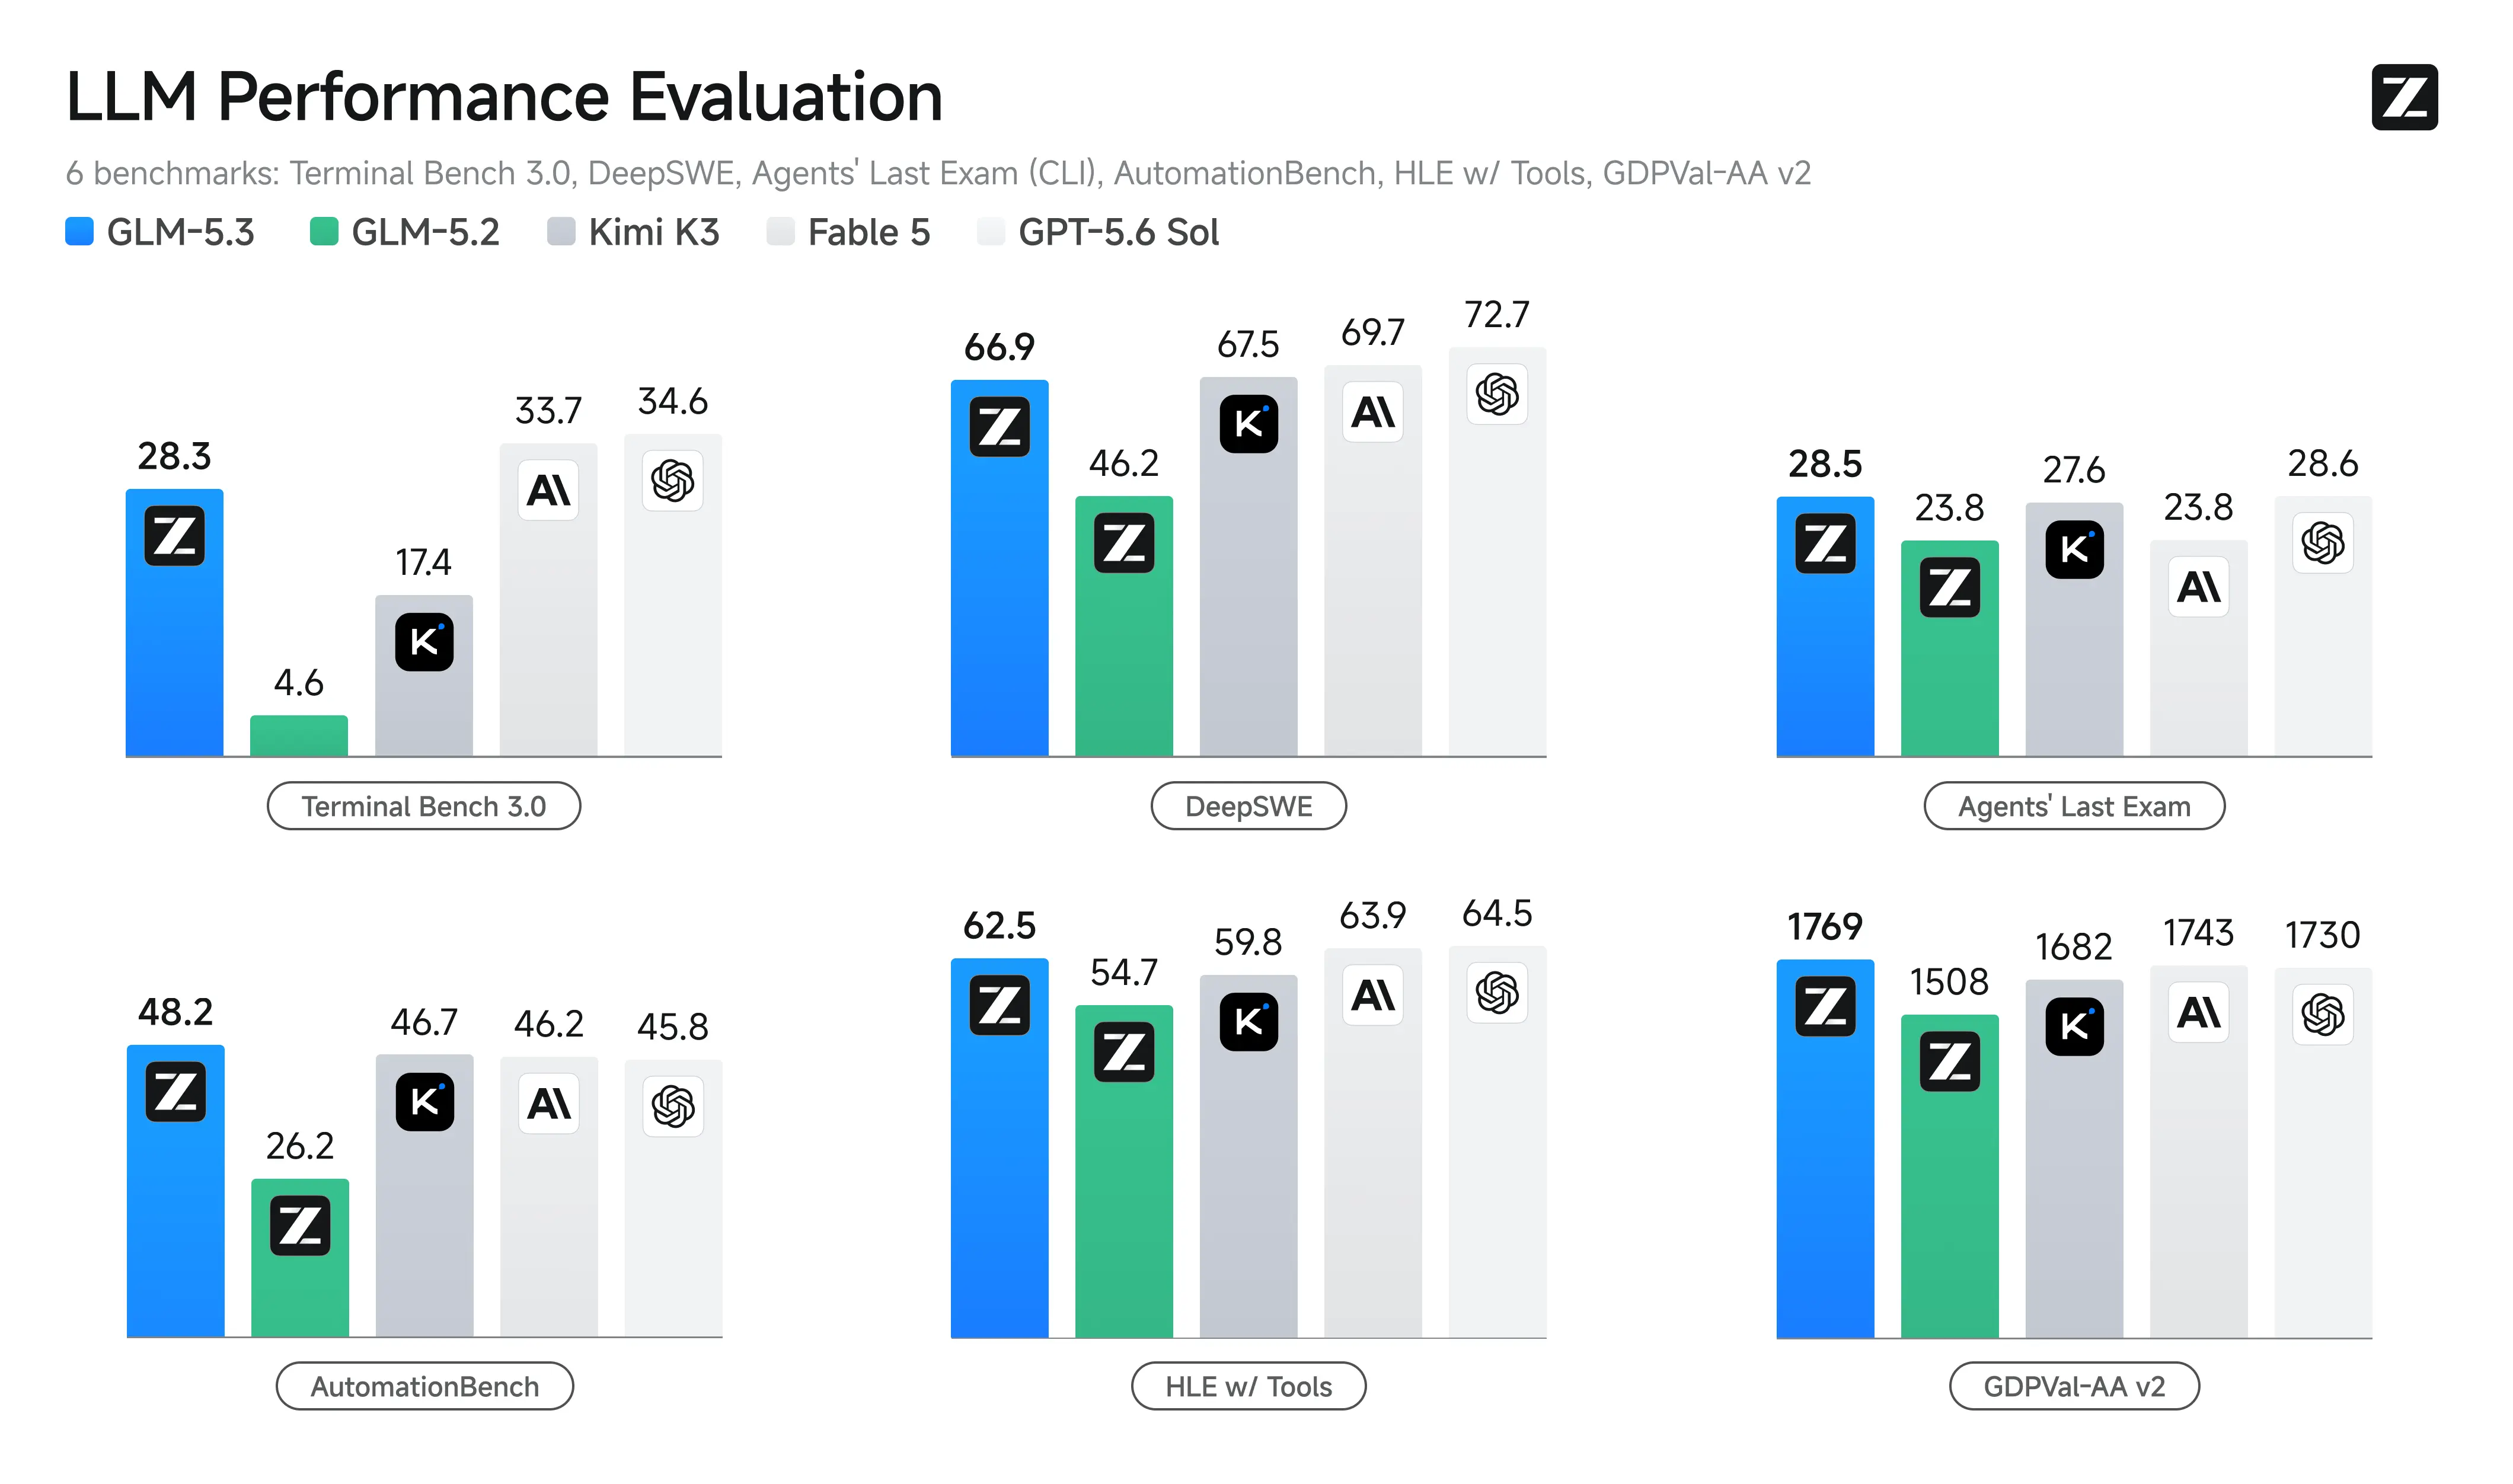
两个 5.3 代表不同优化路线
GLM-5.3 与 GLM-5.3-Flash 名字接近,却不应理解为同一个模型的高低配。Z.ai 官方介绍显示,完整 GLM-5.3 沿用 GLM-5.2 的基础模型,主要通过继续扩大后训练环境、任务和计算,强化复杂 Coding、长链路 Agent 与安全分析能力。官方称其内部代码基准比 5.2 提升 50%,但这仍是厂商口径,需要真实任务复核。
GLM-5.3-Flash 则从新的基础模型出发,是 GLM-5 系列首个原生多模态版本。它约有 320B 总参数和 18B 激活参数,使用稀疏与线性注意力混合架构,重点是以更低推理成本覆盖视觉、长上下文、Coding 和 Agent。一个更偏向把困难任务上限推高,另一个更强调生产效率和能力覆盖。
我的观点:默认模型首先要完成大多数工作
生产系统每天面对的通常不是排行榜最难题,而是大量文档理解、界面截图、常规代码修改、数据整理与工具编排。若 GLM-5.3-Flash 在这些任务上达到可接受质量,同时明显降低费用和等待时间,它作为默认路由可能比一味追求最高能力更有价值。
真正困难的跨仓库重构、长时间研究或安全分析,可以再路由到更强模型。不要要求一个模型同时承担快速默认、极限推理、视觉理解和最终复核。AnyAIS 的意义正在于把模型选择留在服务层:客户端保持同一接入方式,平台根据任务和权限选择不同能力。
什么时候优先 GLM-5.3-Flash
- 输入包含截图、图表、扫描材料或视觉界面,需要同一模型继续生成文字、JSON 或代码。
- 请求量较大,团队更关心单位任务成本、响应速度和缓存输入价格。
- 日常 Coding、文档分析与 Agent 工具调用占多数,希望一个模型覆盖更多常见路径。
- 需要先在 API 中快速验证,再决定是否投入自托管资源。
AnyAIS 当前已经提供 glm-5.3-flash,并标注视觉、流式、函数调用、JSON、Coding、Thinking 与长上下文能力,适合用受限 API Key 做灰度测试。
什么时候需要完整 GLM-5.3 或其他强模型
当任务是复杂系统工程、长链路自主修改、深度漏洞研究,或失败一次的代价远高于调用成本时,应把质量上限放在首位。完整 GLM-5.3 的官方定位更接近这一方向。不过,安全能力增强也意味着更严格的沙箱、网络、凭据和人工审批,不能把更会寻找漏洞的模型直接放进生产网络。
高风险结果最好由不同模型独立审阅,并要求测试、扫描或原始证据支持。第二个模型的作用是发现盲点,不是用多数票替代安全负责人。
开放权重不等于低部署成本
GLM-5.3 与 Flash 的官方权重页已经提供部署资料,但模型规模、显存、推理框架、量化、长上下文 KV Cache 和并发目标都会影响真实成本。能下载权重只代表拥有部署选择,不代表本地一定比 API 便宜。应把硬件折旧、峰值容量、升级、监控与运维时间一起计算。
对多数产品团队,先通过 AnyAIS 以 API 方式测出调用量和质量分布,再判断哪些稳定工作负载值得迁到自托管,风险更低。平台调用与自托管也可以并存:敏感固定任务走内部集群,弹性或前沿模型继续通过统一网关调用。
最后的选型原则
不要问哪个后缀更强,而要问任务是否需要视觉、上限、速度、成本、开放权重或更严格安全边界。以 GLM-5.3-Flash 作为高覆盖候选,以完整 GLM-5.3 和其他强模型处理困难任务,再用独立评测与日志持续调整,这比给所有请求绑定一个“最强模型”更接近可靠生产。
参考资料:
- Z.ai GLM-5.3 官方介绍:https://z.ai/blog/glm-5.3
- GLM-5.3 官方模型卡:https://huggingface.co/zai-org/GLM-5.3
- Z.ai GLM-5.3-Flash 官方介绍:https://z.ai/blog/glm-5.3-flash
- GLM-5.3-Flash 官方模型卡:https://huggingface.co/zai-org/GLM-5.3-Flash
- AnyAIS 模型目录:https://www.anyais.com/models
让模型按工作负载分工
通过 AnyAIS 统一模型入口、权限、计费与日志,为常规、高难和复核任务选择不同模型。
查看可用模型