模型评测 · 2026-08-29
怎么评测 GLM-5.3-Flash:不要只看 Coding 榜单,先看真实工作流
一套面向生产的 GLM-5.3-Flash 评测方案,覆盖真实仓库、长上下文、视觉、JSON、Agent 工具、时延、成本与灰度发布。
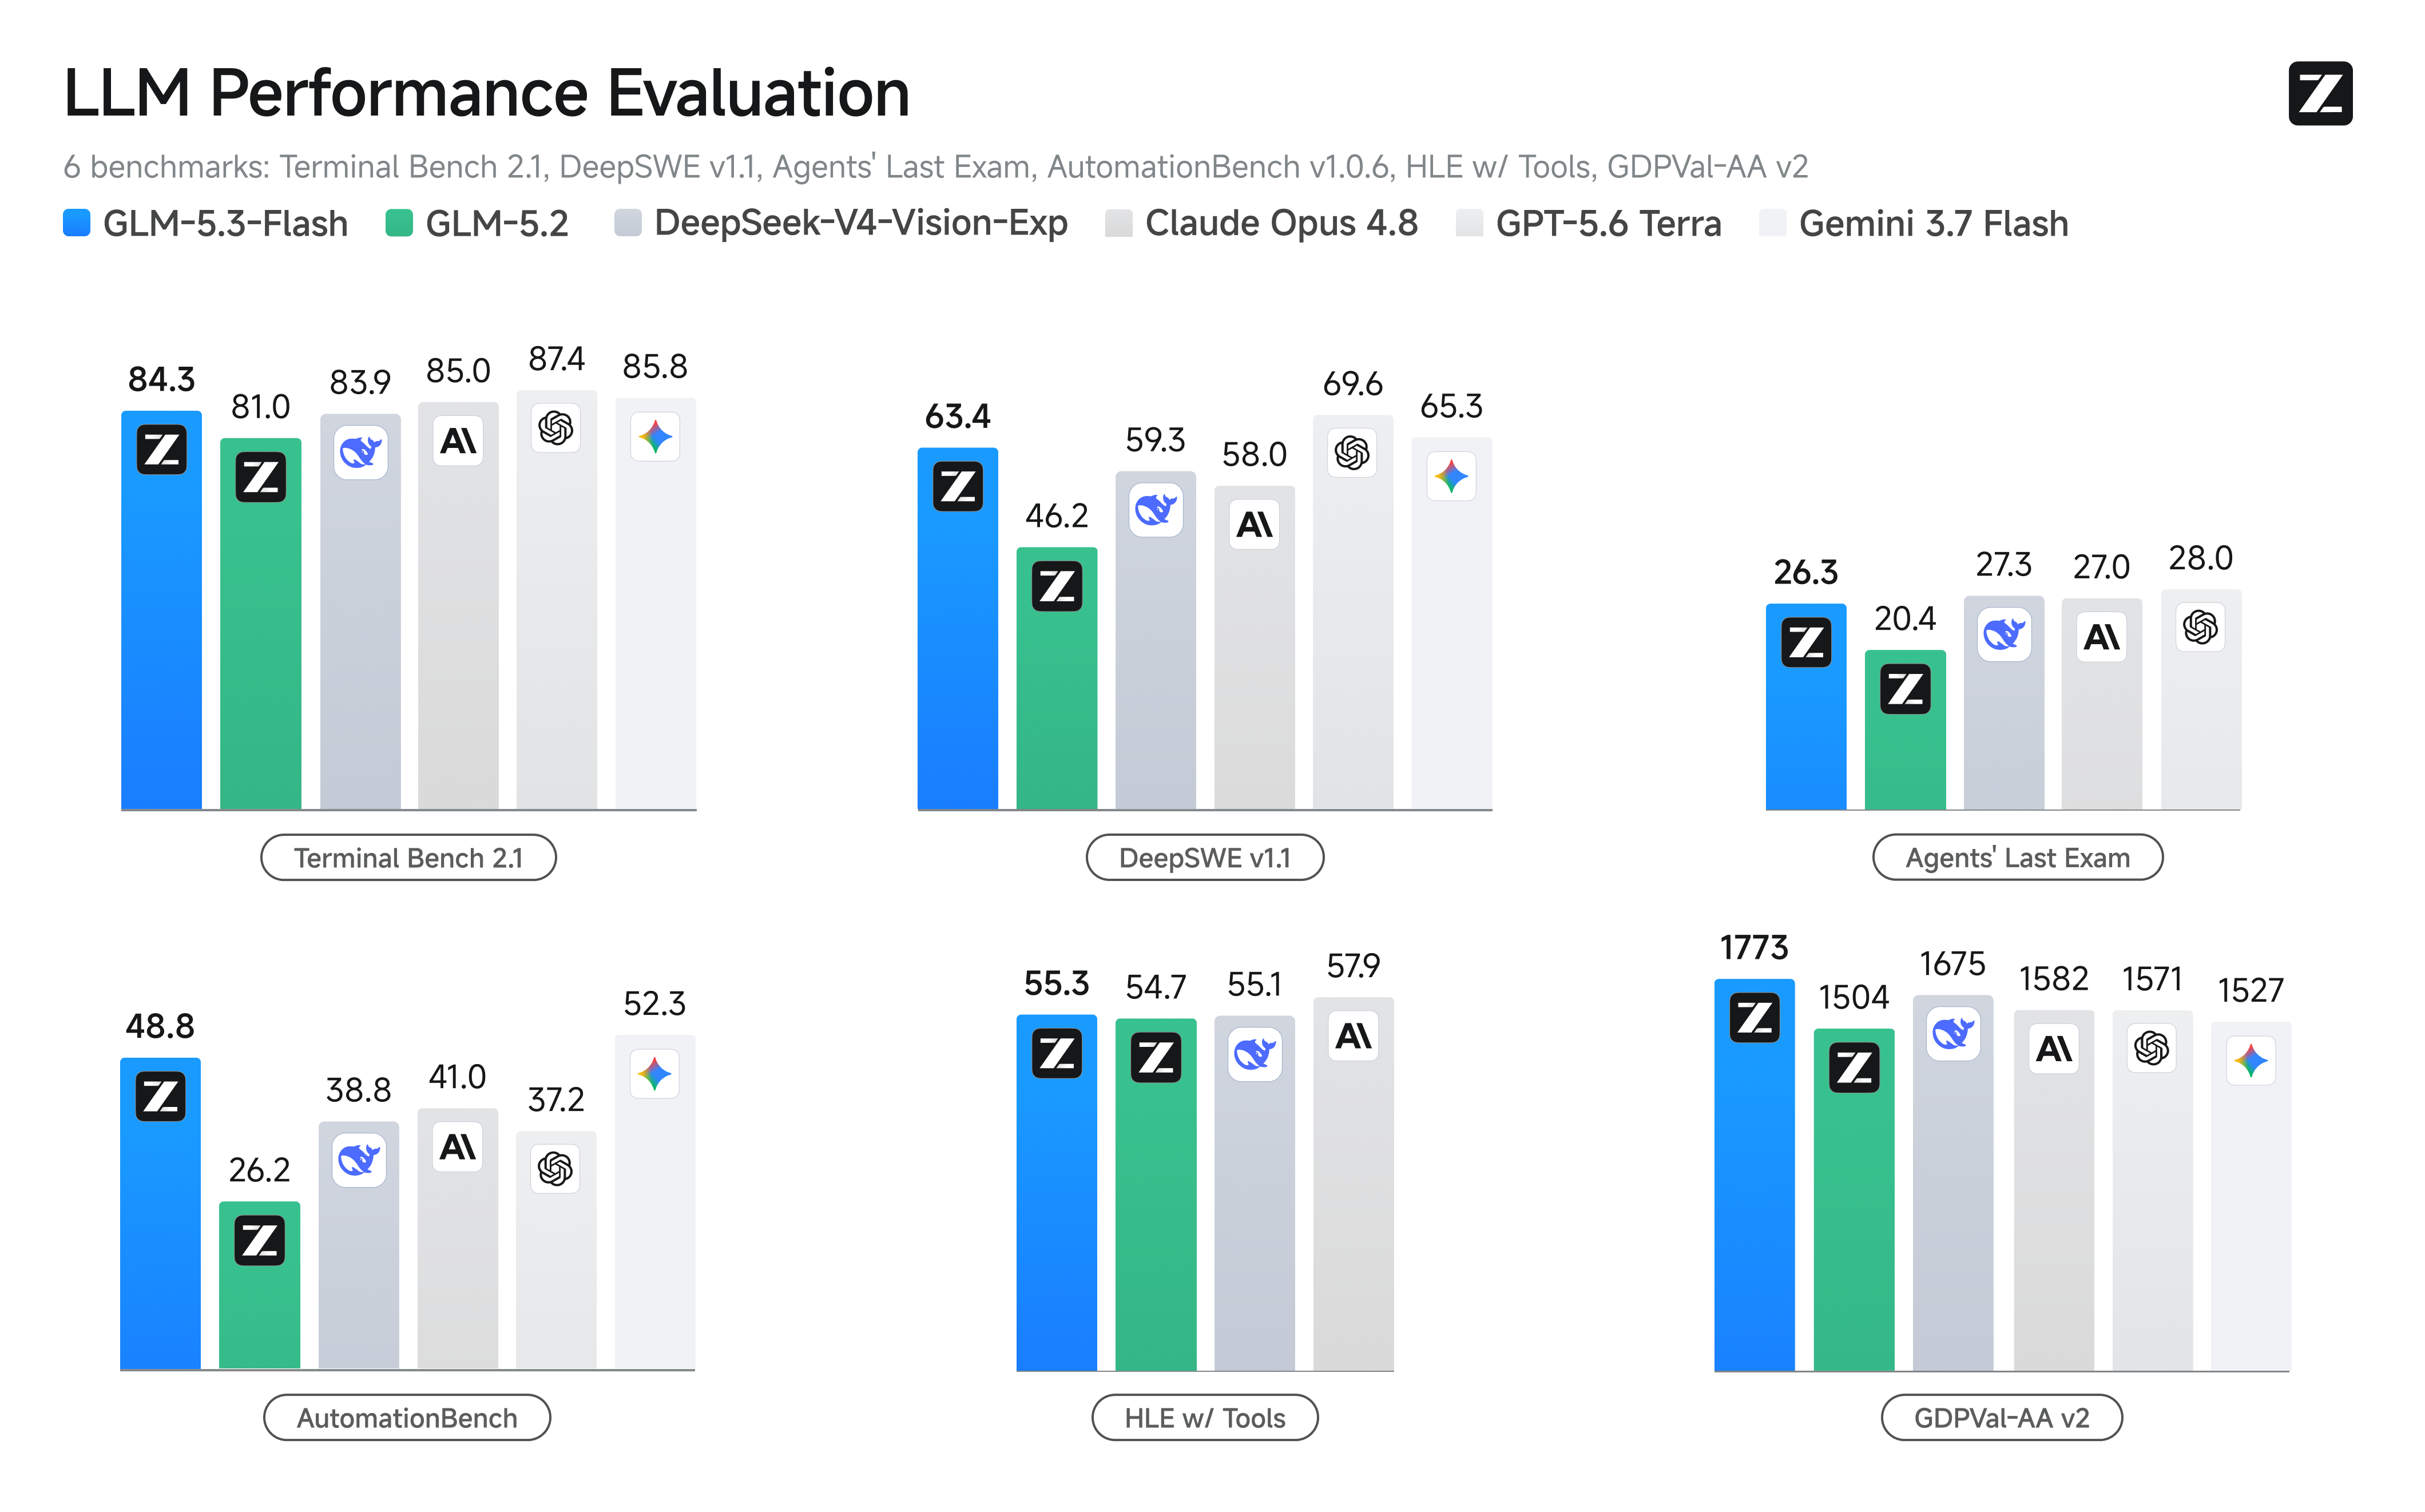
先把官方榜单放回正确位置
GLM-5.3-Flash 的官方材料给出了 Coding、Agent、多模态与效率指标,这些数据能说明研发团队优化了什么,却不能直接回答它是否适合你的生产环境。模型评测真正需要比较的是:同一批真实任务中,哪个方案更常产生可接受结果,需要多少人工修正,消耗多少时间和费用。
因此,评测至少要保留一个当前生产模型作为基线,固定系统提示、工具版本、温度、推理强度和最大输出,并记录失败重试。只拿两个聊天窗口凭印象比较,很容易把提示差异和随机波动误认为模型能力。
第一组:真实代码仓库任务
不要只让模型写孤立函数。样本应来自已经解决的 Bug、跨文件小功能、测试补充、依赖升级和性能排查。每项任务提供相同仓库状态和工具权限,验证补丁能否应用、构建与测试是否通过、是否修改无关文件,以及开发者最终接受了多少代码。
GLM-5.3-Flash 支持 Coding 和多档 Thinking,可以分别测试 medium、high、xhigh。推理更深不一定单位任务更便宜,应同时记录完成率、总输出 Token、工具调用次数、墙钟时间与人工审查分钟数。对于安全、计费和数据迁移代码,再让独立模型只查看需求、diff 与测试证据,专门寻找遗漏,最终仍以可执行测试和人工合并为准。
第二组:长上下文与检索
AnyAIS 当前目录标注 100 万上下文,但评测不应只做大海捞针。可以把关键证据放在文档开头、中间和末尾,加入相似但错误的版本,测试引用是否正确、是否混淆过期内容、无答案时会不会编造。随后逐步增加上下文,观察正确率、首字延迟、总耗时和缓存输入成本。
同一任务还应比较直接长上下文与检索加短上下文。窗口容量只是上限,检索、权限过滤和上下文压缩仍可能更准确、更便宜。DASP 场景则要测试多轮会话恢复后,模型是否继续依据最新事实,而不是抓住早期错误信息。
第三组:视觉与结构化输出
准备真实截图、仪表盘、表格、流程图和低质量图片,分别测试文字识别、空间关系、错误定位与跨图推理。输出要求固定 JSON Schema,并用程序验证字段、类型、枚举和引用区域。只看最终解释很流畅,可能掩盖坐标、数字或状态读错。
关键图片结论应回到原图区域;涉及金额、配置或安全告警时,可以由另一视觉模型独立复核冲突项。模型一致不等于事实正确,低置信度样本仍需人工处理。
第四组:Agent 与工具调用
工具评测要覆盖正确选择、参数完整、权限边界、失败恢复和重复调用。故意加入超时、空结果、提示注入与无权动作,观察模型是否停止、换方案或请求确认。付款、删除、外发和生产变更必须在工具服务端强制审批,不能把模型的自我判断当授权。
第五组:生产经济性
最终看单位业务结果,而不是每百万 Token 单价。至少统计首字延迟、完整耗时、成功请求率、重试率、接受率、单次可接受结果成本和人工接管。通过 AnyAIS 为每个候选模型建立独立 Key 或测试项目,调用日志与费用按同一口径汇总,才容易做公平比较。
上线时先影子运行或开放给内部用户,再按租户和比例扩大。预先定义停止条件与旧模型回退路径。GLM-5.3-Flash 是否更好,不需要一次争论得出答案;一套能持续加入失败样本的评测集,才会随着模型和业务一起进化。
参考资料:
- GLM-5.3-Flash 官方模型卡与评测说明:https://huggingface.co/zai-org/GLM-5.3-Flash
- Z.ai GLM-5.3-Flash 官方介绍:https://z.ai/blog/glm-5.3-flash
- AnyAIS 模型目录:https://www.anyais.com/models
用真实任务比较 GLM-5.3-Flash
在 AnyAIS 中隔离测试 Key、统一调用日志和费用口径,让模型选择建立在可复现证据上。
进入模型目录