开源推荐 · 2026-08-27
开源项目推荐|KServe:在 Kubernetes 上统一管理模型服务生命周期
KServe 面向 Kubernetes 的生成式与预测式 AI 推理,关注多框架部署、扩缩容和标准化服务,是平台团队的基础设施选项。
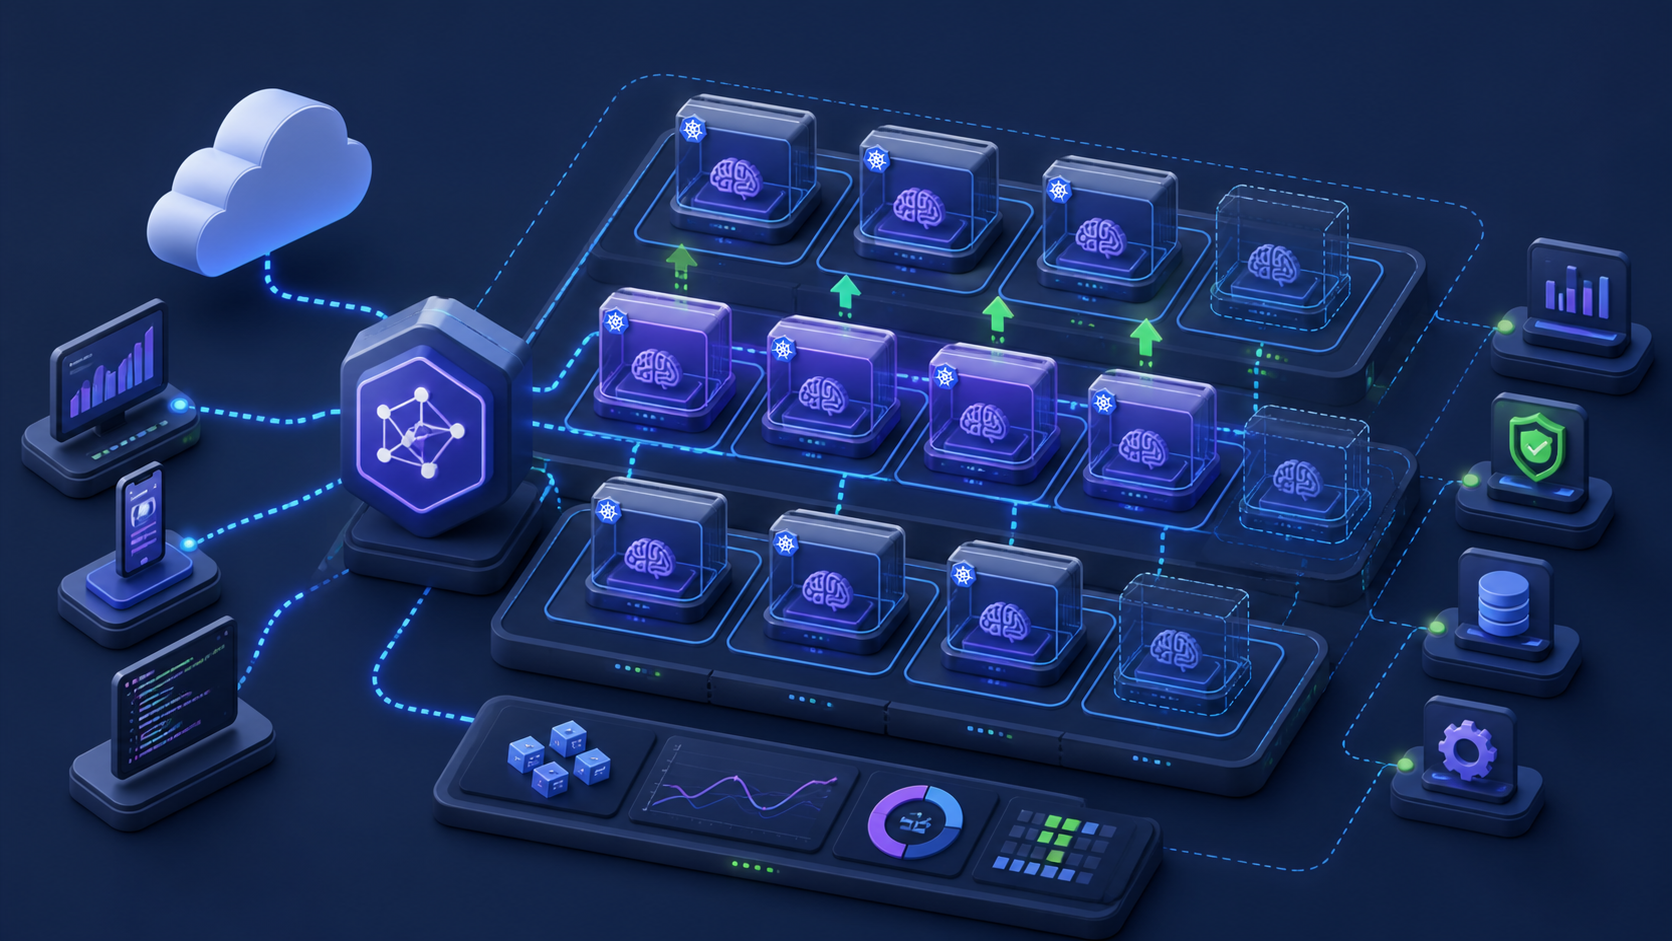
当模型服务不再只有一个实例
vLLM 可以高效提供某个 LLM 服务,但企业通常还会部署分类、Embedding、视觉和传统预测模型。它们使用不同框架,需要发布、扩缩容、流量切换、监控和回滚。KServe 位于更上层,目标是在 Kubernetes 中以标准化方式管理多框架推理服务。
官方仓库:https://github.com/kserve/kserve
它的价值在平台层
KServe 提供面向推理服务的 Kubernetes 资源模型,围绕模型存储、运行时、弹性、流量与可观测性组织部署。平台团队可以为不同模型建立一致的交付流程,而不是让每个算法团队手写 Deployment、Service 和自动扩缩容规则。
对需要灰度模型版本、按需扩容、多租户命名空间或多框架共存的组织,这种统一生命周期很重要。它也让基础设施与模型研发职责更清晰:算法团队交付模型与运行需求,平台团队提供受控服务环境。
不要为了云原生过早引入
KServe 依赖 Kubernetes 运营能力。若团队只有一两个模型、流量不大,也没有成熟集群,引入后的资源、网络、存储、GPU 调度和监控成本可能高于收益。先用托管 API 或单一推理服务验证业务,通常更经济。
自动扩缩容也需要理解模型特性。大权重冷启动可能很慢,缩到零会影响首请求;GPU 节点昂贵,扩容速度与配额要提前演练。不能只配置一个目标并发就期待系统自动达到最优成本。
与 AnyAIS 的职责边界
KServe 管理集群内部的模型部署与弹性,AnyAIS 面向应用提供统一协议、API Key、模型权限、价格、用量和请求日志。多个 KServe 服务可以作为上游渠道注册,业务侧不暴露集群地址,也不需要理解模型在哪个命名空间。
发布新版本时,可以先让少量脱敏样本流向候选服务,对比延迟和输出;关键任务再由独立模型或规则检查,确认质量没有退化后扩大流量。基础设施灰度与内容质量验证结合,回滚依据会更完整。
适合谁
已有 Kubernetes 平台团队、需要管理多种推理框架、模型版本和 GPU 资源的中大型组织,适合评估 KServe。它与 vLLM 并非重复主题:vLLM 优化 LLM 推理引擎,KServe 负责更广泛的集群级服务生命周期,两者可以上下组合。
从 InferenceService 建立统一交付契约
KServe 通过自定义资源描述模型服务,控制面管理生命周期,数据面承担真实推理。平台团队可以把运行时、模型存储、资源、健康检查和流量策略写入可审查配置,并用 Kubernetes 原有权限、命名空间和发布流程治理。算法团队不必为每个框架重新设计服务外壳,应用也不直接依赖集群细节。
KServe V2 推理协议为健康、元数据和推理提供标准接口,可使用 HTTP 或 gRPC。标准协议有助于统一监控和客户端,但具体框架仍可能拥有不同的数据类型、批处理和模型能力。接入一个新 runtime 时,要验证协议兼容、模型加载、输入边界、错误码与指标,而不是只看 Pod 已经 Running。
扩缩容与冷启动要真实演练
Serverless 模式可以按请求扩缩,部分场景支持缩到零,但大模型权重、GPU 节点和镜像下载会显著影响冷启动。团队应分别测试常驻最小副本、缩零恢复、高峰扩容和节点故障,记录请求排队、加载时间、显存、P95 延迟与恢复目标。GPU 配额和模型缓存也要包含在容量计划中。
灰度发布不能只比较 HTTP 成功率。候选版本用固定脱敏样本检查业务通过率、格式和延迟,再由独立模型审阅高风险输出并用人工抽样校准。若新模型质量下降,流量策略和模型资源都要能快速回退。
官方资料
KServe 文档入口:https://kserve.github.io/website/docs/intro
KServe V2 推理协议:https://kserve.github.io/website/docs/concepts/architecture/data-plane/v2-protocol
为多模型集群建立统一生命周期
评估 KServe 的 Kubernetes 推理资源模型,再通过 AnyAIS 暴露稳定应用入口。
访问 KServe 官方仓库