开源推荐 · 2026-08-28
开源项目推荐|Langfuse:看清一次 LLM 请求到底经历了什么
Langfuse 将 LLM traces、评测、指标、Prompt、数据集和实验组织在同一工程平台,适合建立质量与成本闭环。
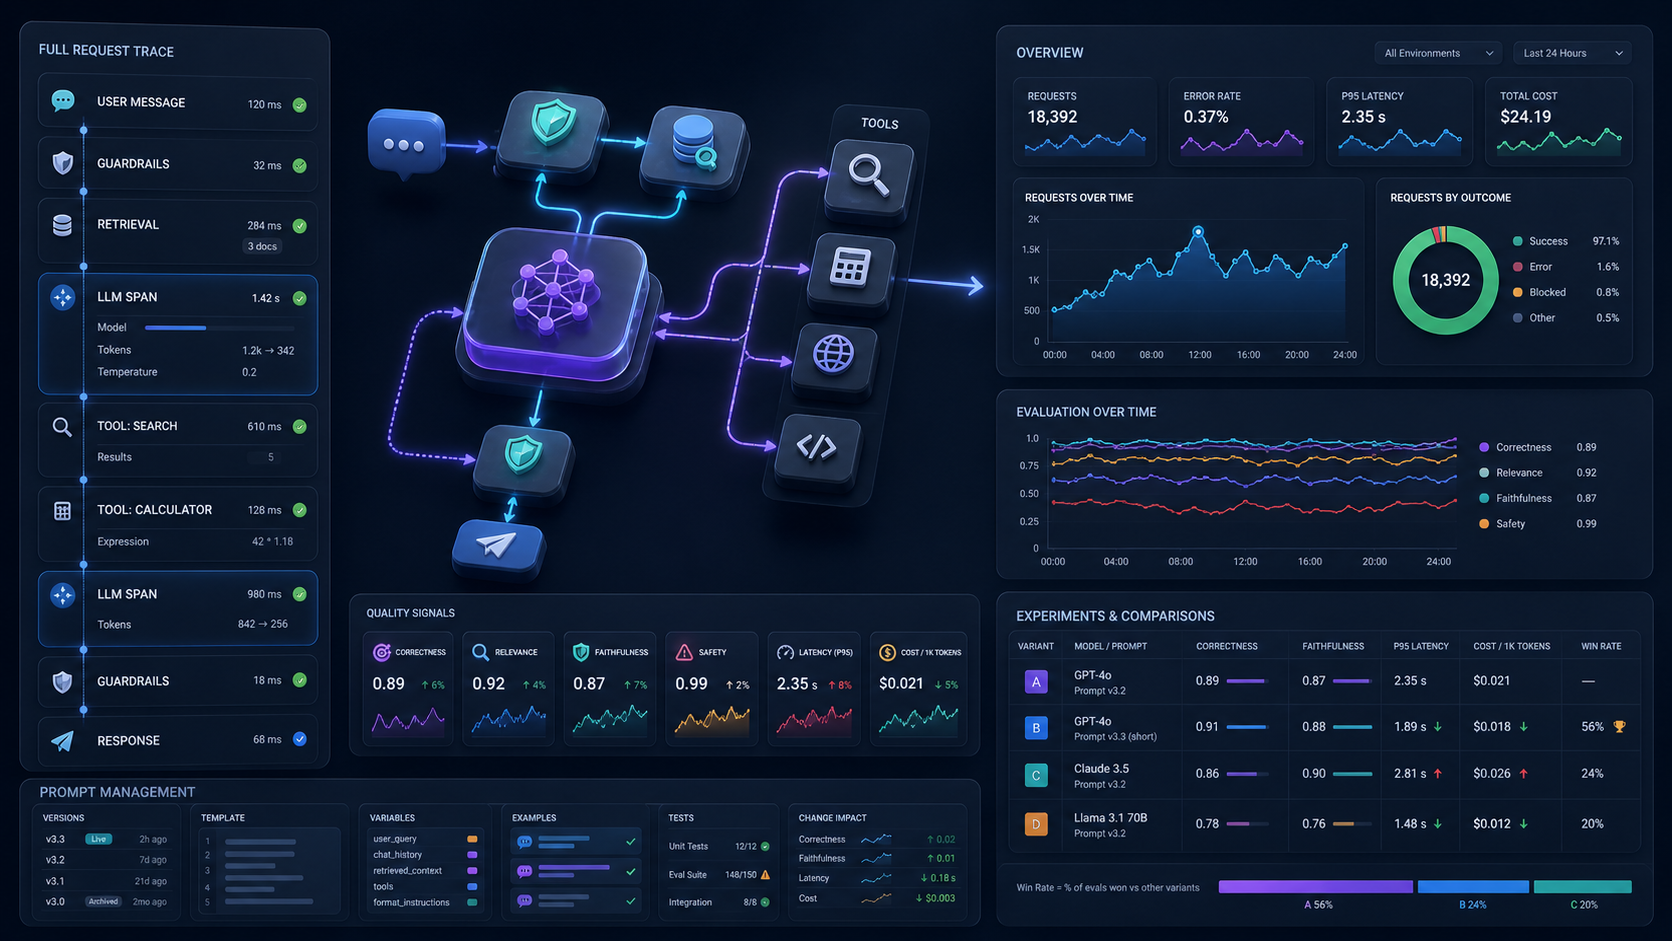
HTTP 200 解释不了 AI 质量
传统监控能告诉你接口是否成功,却无法说明检索了哪些文档、调用了什么工具、Prompt 哪个版本、模型输出为何被用户拒绝。Agent 链路越长,这种盲区越大。Langfuse 是活跃的开源 AI 工程平台,覆盖 LLM 可观测性、评测、指标、Prompt 管理、数据集和实验。
官方仓库:https://github.com/langfuse/langfuse
Trace 把链路重新拼起来
Langfuse 可以把一次用户请求下的模型、检索、工具和其他 span 关联起来,并记录延迟、Token、费用、输入输出与元数据。团队能从某个差评下钻到具体步骤,也能按模型、Prompt 版本或环境比较指标。
数据集和实验让线上失败样本回到离线评测,Prompt 更新不再靠主观试聊。它还支持与 OpenTelemetry、常用模型 SDK 和框架集成,适合已有复杂 AI 栈的团队。
先设计观测边界
输入输出可能包含个人信息、商业秘密和密钥。接入前应确定哪些字段采集、如何脱敏、谁能查看、保留多久。不是记录越多越好;能定位问题且符合合规要求才是目标。
指标也要对应业务。通用相关性分数无法替代客服解决率、代码合并率或合同字段准确率。团队应把技术 trace 与最终用户反馈连接,同时保留抽样人工审核。
让独立评价成为一条可见 span
开放式输出可以由另一个模型依据固定量表评分,但评价调用本身也应进入 trace:使用什么模型、看到了哪些证据、花费多少、与人工判断是否一致。这样自动评测不会成为新的黑盒,也能定期校准偏差。
与 AnyAIS 的组合方式
AnyAIS 已提供网关侧鉴权、路由、用量和请求日志,Langfuse 更适合深入应用内部的 trace、Prompt、数据集与评测。两者分层使用:网关回答谁调用了哪个服务、花了多少,Langfuse 回答应用内部哪个步骤影响质量。
适合谁
已有 RAG、Agent 或多模型应用,需要系统化调试、Prompt 版本、实验和质量度量的团队,适合 Langfuse。若尚未定义业务通过标准,先建立样本和反馈,再引入平台;否则丰富看板也难以产生行动。
先把 Trace 结构设计正确
一次用户请求可作为一个 trace,检索、模型调用、工具和业务校验分别成为 observation;连续任务再用 session 归组。步骤名称和结构应保持稳定,因为看板与评测规则依赖这些字段。每次生成关联 Prompt 版本、模型、环境、Token、耗时和用户反馈,才能从投诉追到具体环节。
建立从线上失败回到离线实验的循环
线上 trace 中的新边界样本应脱敏后进入数据集。发布新模型或 Prompt 前,在同一数据集比较旧版本;结构字段、工具参数和业务规则使用确定性检查,语气、相关性等开放标准再交给独立模型评分。自动评分需与人工标注校准,并保留评分模型、量表和证据。
输入输出可能包含个人信息、密钥与商业资料,应按字段脱敏,设置访问权限、保留期限和采样率。自托管增加数据控制,但备份、升级和权限仍由团队负责。
参考资料:
- Langfuse 可观测性与 Trace:https://langfuse.com/docs/observability/overview
- Langfuse Trace 最佳实践:https://langfuse.com/docs/observability/best-practices
- Langfuse 评测核心概念:https://langfuse.com/docs/evaluation/core-concepts
- Langfuse Prompt 与 Trace 关联:https://langfuse.com/docs/prompt-management/features/link-to-traces
把 AI 质量问题定位到具体步骤
用 Langfuse 观察应用内部链路,用 AnyAIS 管理统一入口与用量。
访问 Langfuse 官方仓库