开源推荐 · 2026-08-28
开源项目推荐|LlamaIndex:让企业数据真正进入 AI 应用
LlamaIndex 围绕文档、数据连接、索引、检索与 Agent 构建能力,适合把分散知识转化为可引用的 AI 上下文。
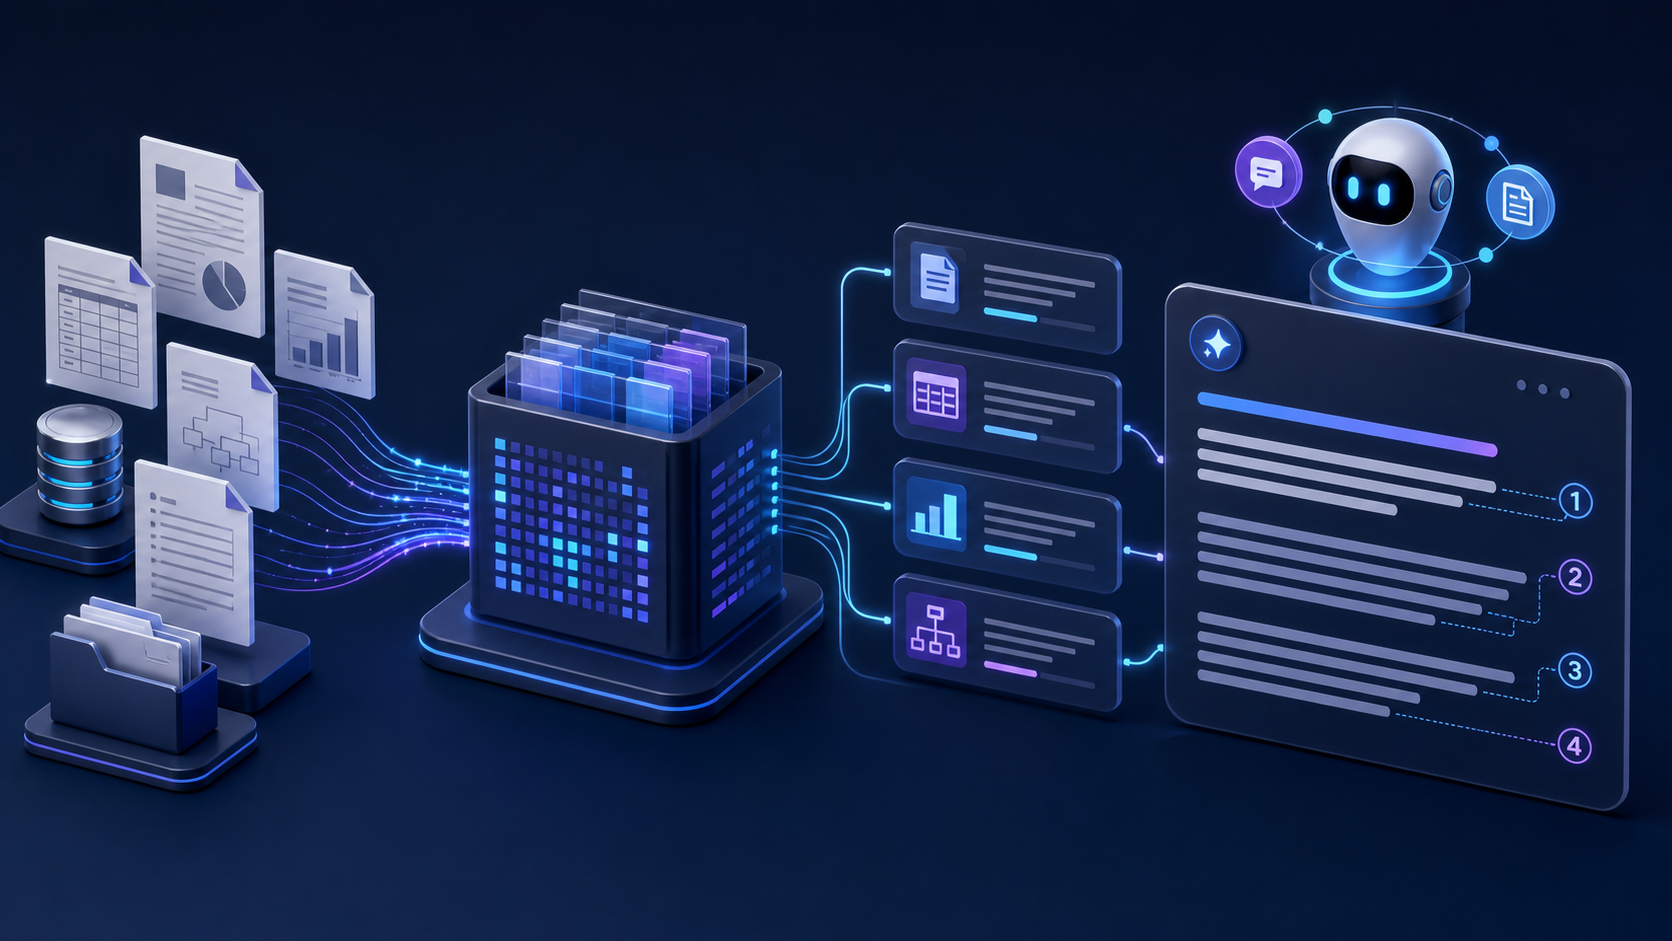
模型不知道你的内部事实
企业 AI 最常见的问题不是模型不会表达,而是缺少可靠上下文。合同、产品文档、工单和数据库分散在不同系统,格式和权限也不一致。LlamaIndex 聚焦数据与文档 Agent,提供连接、解析、索引、检索和查询组合,因此成为 RAG 生态中的热门项目。
官方仓库:https://github.com/run-llama/llama_index
从数据管道到应用查询
LlamaIndex 提供大量数据连接和可组合组件,帮助团队把原始内容转换为节点、索引并在查询时取回相关证据。开发者可以控制切分、元数据、检索、重排和响应合成,而不是只使用一个黑盒上传文档按钮。
它适合知识助手、文档分析、企业搜索、研究工具和需要引用来源的 Agent。与 Qdrant 的区别是:Qdrant 是向量数据库,LlamaIndex 是围绕数据进入 AI 应用的框架,二者经常组合。
RAG 的难点在数据而非演示
文档更新、重复内容、表格、扫描件、权限过滤和无答案处理都会影响质量。切分长度没有通用最佳值,应按文档结构和问题类型测试。检索命中也不代表最终答案正确,响应必须保留来源并允许用户查看证据。
评测时要把是否找到正确片段和答案是否忠于片段分开。可以让独立模型只检查引用是否支持结论,再对低分样本人工复核。这样能判断问题出在解析、检索还是生成,而不是笼统地说模型不好。
与 AnyAIS 的组合方式
LlamaIndex 负责数据管道和查询逻辑,AnyAIS 提供 Embedding、推理模型、文件分析、MCP、API Key 与用量日志。不同数据阶段可以选择不同能力,而不在应用中保存多家密钥。连续研究场景还可用 DASP sid 保存会话与恢复事件。
适合谁
数据来源多、需要定制检索与引用、愿意用代码控制 RAG 细节的团队,适合 LlamaIndex。如果只需快速做一个知识库应用,Dify 可能更快;当数据权限、结构和质量成为核心竞争力,再进入 LlamaIndex 这一层更合适。
把索引当成持续的数据产品
生产知识库不能只做一次上传。文档需要稳定 ID、来源、版本、更新时间、租户与访问范围;变更能传播到节点与索引。LlamaIndex 的 IngestionPipeline 可组合切分、元数据提取和 Embedding,并缓存节点转换,适合构建可重复导入流程。
缓存不替业务处理权限。租户、部门、保密级别和生效时间应成为节点元数据,并在检索前过滤;不要先取回无权内容再让模型忽略。删除源文档时同步清理派生节点和索引。
分开测检索与回答
RAG 出错时,先检查正确片段是否进入候选,再检查回答是否忠于片段。检索层用参考问题集计算命中率、MRR;生成层评估忠实度、相关性、引用和无答案处理。这样才能定位解析、切分、过滤、重排或模型问题。
开放回答可由独立模型按量表复核,但关键事实仍要回到原文,抽样结果由业务人员校准。评测集应包含过期文档、重复版本、权限冲突、表格和无法回答的问题。
让证据成为产品界面的一部分
结果应返回标题、版本、页码或段落位置;证据不足时明确拒答。记录过滤条件、召回节点、重排结果、模型和反馈,让线上问题进入下一轮改进。
AnyAIS 可为 LlamaIndex 统一 Embedding、推理模型、文件能力、密钥、配额和调用日志。框架负责数据与查询逻辑,平台负责模型入口和治理,二者边界清楚后更容易替换单一组件。
参考资料:
- LlamaIndex RAG 介绍:https://developers.llamaindex.ai/python/framework/understanding/rag/
- LlamaIndex Ingestion Pipeline:https://developers.llamaindex.ai/python/framework/module_guides/loading/ingestion_pipeline/
- LlamaIndex 评测指南:https://developers.llamaindex.ai/python/framework/module_guides/evaluating/
把企业数据变成有来源的 AI 上下文
用 LlamaIndex 构建数据管道,用 AnyAIS 统一模型、Embedding 与文件能力。
访问 LlamaIndex 官方仓库