开源推荐 · 2026-08-28
开源项目推荐|PaddleOCR:从扫描图片中提取多语言文字与结构
PaddleOCR 提供多语言文字识别与文档结构能力,适合票据、扫描件、表格和图像资料数字化。
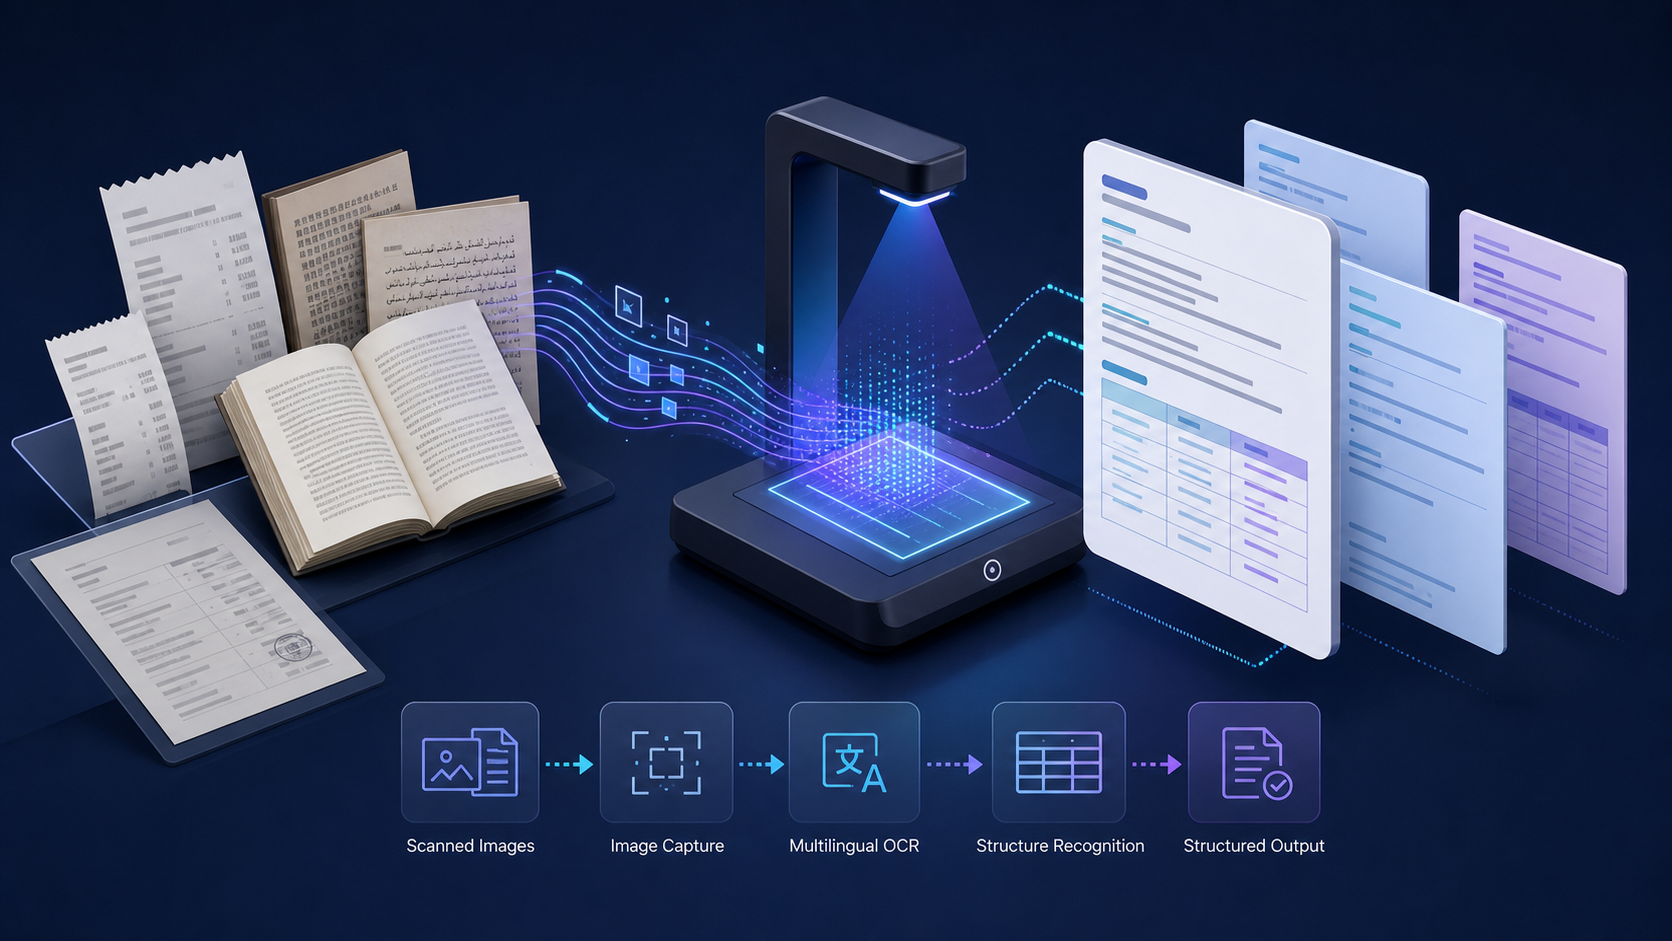
扫描件需要先看得见
很多 PDF 实际只有图片,收据、证件、书页和历史档案也没有可检索文本。PaddleOCR 是成熟而热门的 OCR 工具包,覆盖大量语言,并持续扩展文档结构化能力,适合把图像和扫描文档转成下游 AI 可用的数据。
官方仓库:https://github.com/PaddlePaddle/PaddleOCR
它的核心场景
PaddleOCR 可用于文字检测、识别、方向处理、表格与版面相关任务,适合票据录入、档案数字化、图像搜索、表单处理和 RAG 预处理。轻量模型与丰富部署选项让它可以在服务器或边缘环境中使用。
它与 Docling 的主题不同:PaddleOCR 重点解决像素到文字与布局,Docling 更关注完整文档转换和统一结构。扫描件流程常先用 OCR,再进入文档解析、检索和生成。
准确率必须按业务字段衡量
平均字符准确率可能掩盖关键错误。金额、小数点、日期、证件号和表格列错一位就会影响业务。评测集应覆盖真实拍摄角度、模糊、印章、手写和多语言,并为关键字段设置格式与校验规则。
对无法通过规则的结果,可以让视觉模型依据原图做第二次核对,但不要让同一识别链自我确认。低置信度或两个结果冲突时进入人工队列,保留原图区域和识别版本以便审计。
与 AnyAIS 的组合方式
PaddleOCR 负责本地识别,AnyAIS 提供视觉模型、文本推理、文件分析 MCP、异步任务和用量管理。简单文件走 OCR,复杂语义问题交给模型;路由可根据质量和成本分层。
适合谁
需要多语言 OCR、扫描件与票据结构化,并希望自托管识别能力的团队,适合 PaddleOCR。上线前用业务字段而非演示截图评估,才能知道它是否真的满足生产要求。
先区分 OCR 与文档解析
OCR 的直接产物通常是文字、位置与置信度;文档解析还要恢复阅读顺序、标题层级、表格结构和图片关系。两者可以使用同一工具链,但验收指标不同。搜索、归档或 RAG 项目应先明确需要可检索文本,还是需要能稳定还原业务字段与版面的结构化结果,避免用漂亮的演示页面替代真实验收。
PaddleOCR 同时提供本地安装与官方托管 API。敏感文件、固定批量或离线场景更适合本地部署;快速验证时可评估托管接口。托管任务记录超时、任务 ID 与结果期限,本地任务固定模型、依赖和预处理版本,保证问题可复现。
建立分层评测集
评测应按发票、合同、表单等类型分组,覆盖旋转、阴影、低分辨率、印章、多栏和混合语言。第一层衡量文字识别,第二层检查金额、日期、编号和表格,第三层验证文档能否进入检索或自动化流程。
关键字段可以通过格式、合计关系和主数据做确定性校验。无法通过规则的样本再交给独立视觉模型对照原图裁剪或另一条 OCR 链复核;两路结果冲突时进入人工队列。这里的第二模型只能补充证据,不能代替业务规则与人工授权。
保留从结果回到原图的路径
生产数据不应只保存最终文本。字段应关联文件版本、页码、边界框、模型和置信度。流程依次完成方向校正、识别、版面解析、归一化、规则校验与低置信度分流,并记录失败原因。
清晰页面可先走本地轻量识别,复杂版面或低置信度样本再进入文档解析或视觉模型。AnyAIS 承接后续视觉理解、异步任务、配额与记录,让 OCR 专注识别,业务链路保持可治理。
参考资料:
- PaddleOCR 官方文档首页:https://www.paddleocr.ai/main/en/index.html
- PaddleOCR 官方 API 命令行文档:https://www.paddleocr.ai/latest/en/version3.x/inference_deployment/serving/paddleocr_official_api/cli.html
- PaddleOCR 官方 API Python 文档:https://www.paddleocr.ai/latest/en/version3.x/inference_deployment/serving/paddleocr_official_api/python.html
把扫描图片变成可验证的结构数据
用 PaddleOCR 识别文字,用 AnyAIS 补充视觉理解、推理和异步任务。
访问 PaddleOCR 官方仓库