开源推荐 · 2026-08-27
开源项目推荐|Promptfoo:把 Prompt、Agent 与 RAG 测试放进 CI
Promptfoo 用声明式配置比较模型与 Prompt,执行断言、评测和红队测试,帮助 AI 变更拥有可重复的发布门槛。
AI 也需要回归测试
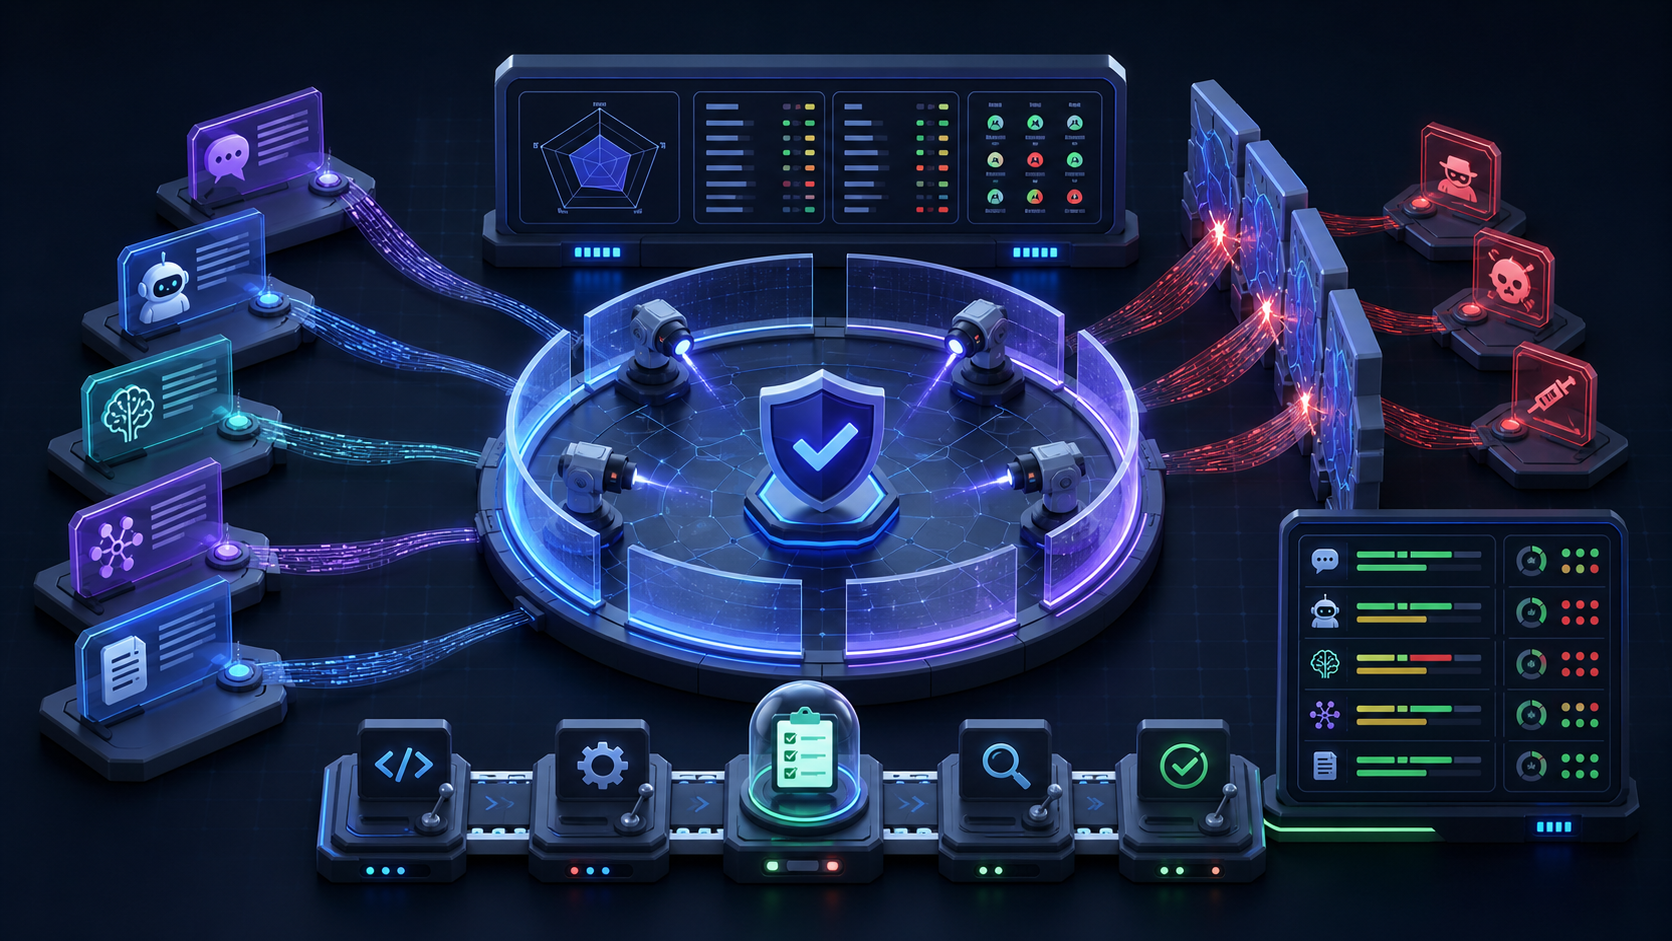
Prompt 改一个词、模型升级一个版本,输出就可能变化。若团队只在上线前手工问几个问题,边界错误和安全退化很难发现。Promptfoo 专注测试 Prompt、Agent 与 RAG,支持模型比较、断言、自动评测、红队与 CI/CD 集成,是当前热门的 AI 质量工具。
官方仓库:https://github.com/promptfoo/promptfoo
用配置描述实验矩阵
团队可以定义测试输入、多个 Prompt 或模型、期望断言与评分方法,然后批量运行并比较结果。确定性任务检查 JSON、关键词或自定义脚本;开放式任务则结合相似度、规则或模型评价。配置可进入 Git,让每次发布使用同一组样本。
红队能力用于探索提示注入、越权、数据泄露和有害输出等风险。它不能证明系统绝对安全,却能让常见攻击持续进入回归测试,而不是只在安全评审当天执行一次。
评价模型不是最终真相
用模型给模型打分很高效,但可能偏爱某种表达、忽略领域事实。好的做法是把评价量表写清楚,隐藏候选身份,使用与生成不同的模型,并定期用人工标注计算一致性。关键决策应保留原始输出和审阅理由,低一致度样本进入人工复核。
与 AnyAIS 的组合方式
Promptfoo 可以通过 AnyAIS 的兼容入口同时调用多个逻辑模型,测试配置只管理一个服务地址和受限 API Key。平台日志记录实际模型、Token 和费用,测试报告记录质量与安全,团队因此能比较每个合格结果的成本。
对生产样本要先脱敏,并为评测 Key 设置模型白名单、额度和速率。CI 失败时输出足够诊断信息,但不要把敏感 Prompt 公开到构建日志。
适合谁
正在频繁更新 Prompt、模型、Agent 或检索流程,需要发布门槛与红队回归的团队,适合 Promptfoo。它与 Langfuse 不重复:Promptfoo 更偏离线测试和 CI,Langfuse 更偏运行时可观测、数据集和实验;两者可共同组成质量闭环。
把测试结果变成发布门槛
Promptfoo 的 assertion 可以检查精确值、包含关系、JSON 结构,也可以关注延迟与成本等指标。团队应把确定性检查放在前面:输出 Schema、必填字段、禁止表达和工具参数可以直接由规则判断;只有语义质量难以程序化时,再引入模型评分。这样既减少评测费用,也让失败原因更容易解释。
进入 CI 后,不要只生成一份好看的 HTML 报告。关键测试应通过明确阈值控制构建结果,并同时保留 JSON 或 JUnit 等机器可读输出。模型、Prompt、数据集和评测配置都记录版本,才能在失败时回答是哪项变化造成回归。对随机性较强的任务,可以重复运行并观察稳定区间,而不是把单次分数当成事实。
红队测试要覆盖产品真实权限边界,例如提示注入、越权工具调用、跨会话数据和过度代理。生成攻击和模型评分本身也可能调用外部推理服务,生产数据必须先脱敏,并根据官方数据处理说明选择本地或受控的生成与评分方式。关键样本再由独立模型和人工分别审阅,避免同一种评价偏好同时影响生成与验收。
官方资料
Promptfoo 断言与指标:https://www.promptfoo.dev/docs/configuration/expected-outputs/
Promptfoo CI/CD 集成:https://www.promptfoo.dev/docs/integrations/ci-cd/
Promptfoo 数据处理说明:https://www.promptfoo.dev/docs/red-team/troubleshooting/data-handling/
为每次 AI 变更建立可重复门槛
让 Promptfoo 运行测试矩阵,让 AnyAIS 统一候选模型、权限和费用。
访问 Promptfoo 官方仓库