开源推荐 · 2026-08-27
开源项目推荐|whisper.cpp:在本地设备上高效完成语音识别
whisper.cpp 以 C/C++ 实现 Whisper 推理,支持多种硬件与量化,适合离线转写、边缘设备和隐私语音场景。
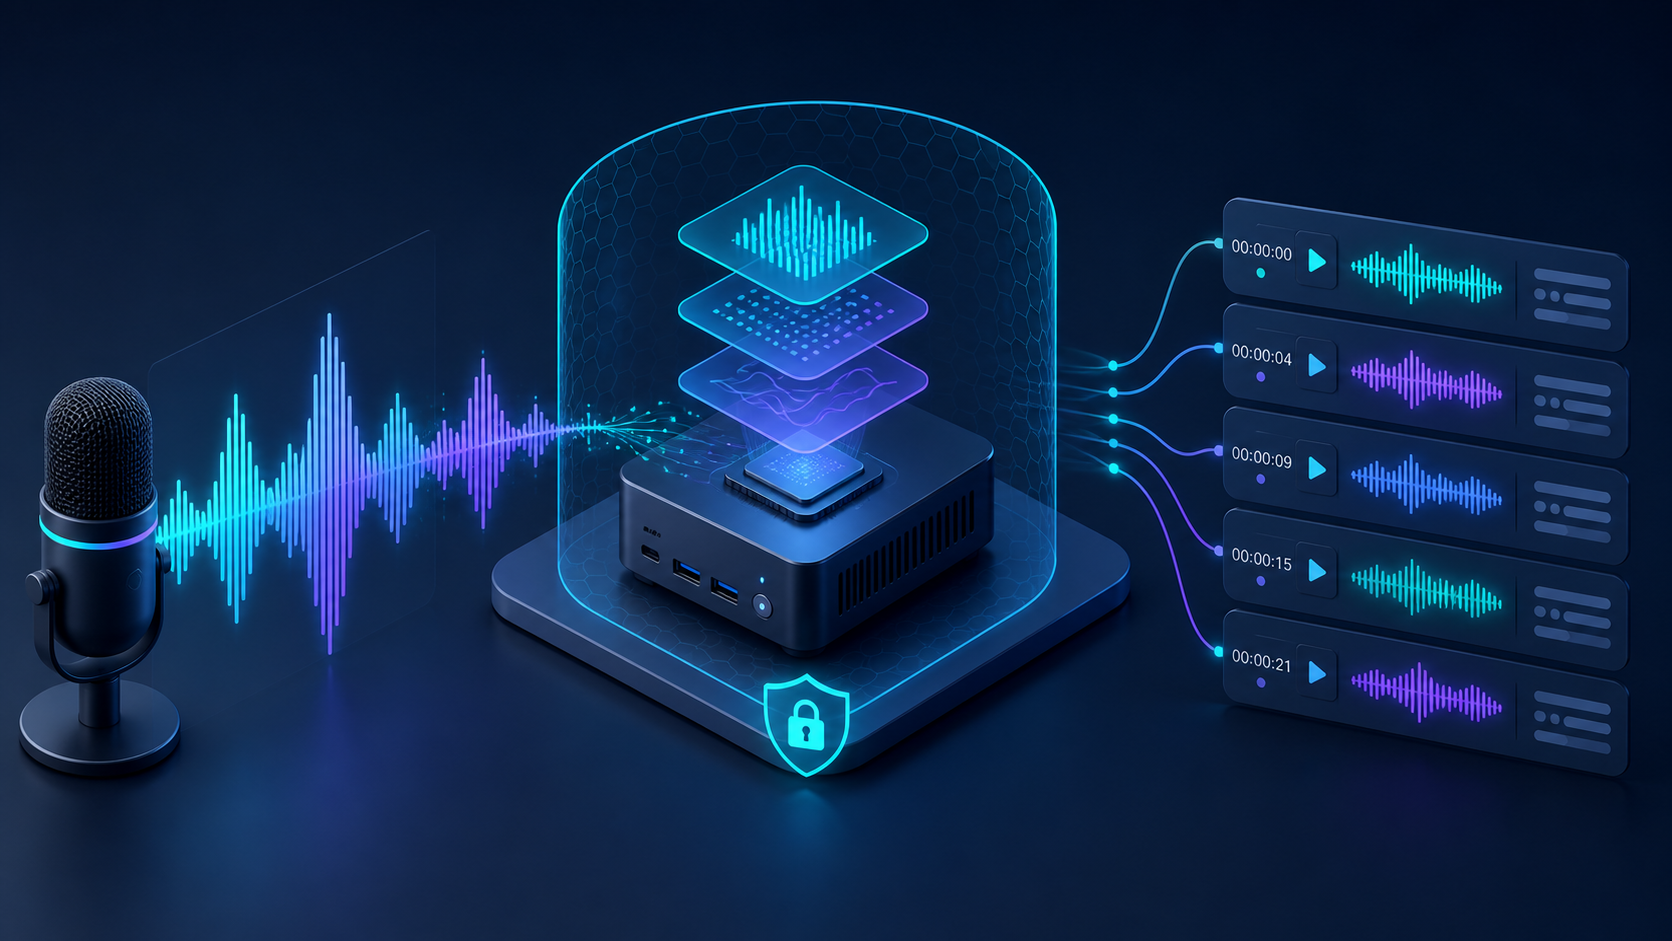
语音识别不一定要上传云端
会议、访谈、客服和个人语音包含大量敏感信息,网络与云费用也会限制长音频处理。whisper.cpp 以 C/C++ 实现 Whisper 模型推理,支持多平台、量化与硬件加速,是本地和边缘语音识别领域的热门项目。
官方仓库:https://github.com/ggml-org/whisper.cpp
为什么适合边缘与离线
项目强调较少依赖和广泛平台支持,可在桌面、服务器甚至资源受限设备运行。量化模型降低内存和存储需求,适合离线字幕、会议转写、语音笔记和本地搜索。数据不离开设备,也减少了不必要的外发风险。
它解决的是语音到文本,不负责完整会议纪要、说话人业务身份、知识检索或行动项执行。后续总结和分析仍需要文本模型与业务流程。
识别质量受音频条件影响
口音、噪声、多人重叠、专业术语和采样质量都会改变准确率。团队应以真实音频测字错率、专有名词、时间戳和处理速度,而不是只用清晰演示录音。量化越激进,资源越省,但可能带来质量变化。
关键会议或合规记录不能只相信单次转写。可以用词表和规则检查实体,让另一个模型对照音频片段或第二路转写定位冲突,最终保留人工确认和原始音频引用。
与 AnyAIS 的组合方式
whisper.cpp 在设备或私有服务器完成转写,结果再通过 AnyAIS 的文本模型生成摘要、行动项和标签。DASP sid 可承接持续会议助手,会话中保留可恢复事件;平台统一管理后续模型、用量和权限。
适合谁
需要离线、隐私、低成本长音频或跨平台语音识别的开发者和团队,适合 whisper.cpp。若追求托管弹性和免运维,可以使用云语音 API;两者可通过统一服务层按场景并存。
模型大小与量化需要一起评测
whisper.cpp 支持不同 Whisper 模型和整数 4、5、8 bit 等量化形式。更小模型或更激进量化通常能降低存储与内存压力,但质量和速度变化依赖硬件、语言与音频条件,不能直接套用别人的结论。团队应固定一组包含安静会议、噪声、口音、专业术语和长静音的样本,记录字错率、实体准确率、实时系数、峰值内存和能耗。
对中文会议,除了整体字错率,还要单独检查人名、产品名、数字、日期与否定词。字幕场景关注时间戳和断句,客服场景关注说话人边界,检索场景关注关键词召回。升级模型、量化或 VAD 参数后用同一批音频回放,关键记录再让独立模型对照原音频与第二路转写指出冲突,最终由人员确认。
服务器示例不应直接裸露公网
项目提供可接收音频文件的 HTTP server 示例,也提供并发压测脚本。官方说明特别提醒:不要以管理员权限运行,文件上传与格式转换需要放在沙箱中,并验证、清理输入。生产服务还应限制文件类型、大小、时长、并发与处理超时,将临时文件放在独立目录并按生命周期清理。
外部访问通过反向代理和业务身份认证,不把示例端口直接开放。任务创建使用幂等键,长音频切分时保留时间偏移,失败与部分完成要有明确状态。原始音频、转写文本和日志采用不同权限与保留期限,避免本地推理虽然保护了上传路径,却在后处理环节重新泄露数据。
性能测试要贴近目标设备
官方仓库包含 whisper-bench 与服务器压测方式。测试应记录 CPU 或 GPU、线程数、模型文件、量化、提交版本和音频长度,并区分模型加载与实际推理时间。桌面工具追求单任务响应,边缘设备关注持续功耗,服务器则需要观察并发下的排队和尾延迟,三者不能用同一数字评价。
官方资料
whisper.cpp 官方仓库:https://github.com/ggml-org/whisper.cpp
whisper.cpp HTTP server 示例:https://github.com/ggml-org/whisper.cpp/blob/master/examples/server/README.md
whisper.cpp 模型说明:https://github.com/ggml-org/whisper.cpp/blob/master/models/README.md
让语音留在本地,让结果进入统一 AI 流程
用 whisper.cpp 完成离线转写,用 AnyAIS 进行摘要、分析与会话管理。
访问 whisper.cpp 官方仓库